
热陈互联备库报表被取消该升档吗?恢复冲突与主库空间怎样验收
发布时间:2026/11/2 7:40:31来源:游吧乐编辑
把报表搬到PostgreSQL备库,主库负载下来了,长查询却隔一阵就被取消。若日志指向恢复冲突,直接把热陈互联的服务器订单升档,可能只缩短一部分执行时间,却没有解决报表与复制重放争用同一份数据历史的问题。采购前应先约定这台备库的职责:它是随时接管业务的候选机,还是允许数据稍旧、优先完成报表的分析机。两种职责能接受的等待时间不同,也会把存储压力留在不同位置。
先保留一次失败现场,再决定买什么
只留一张CPU曲线,很难证明扩容有用。应同时保存失败时间、查询开始时间、数据库日志里的取消原因,以及那一段时间接收和重放位置的变化。PostgreSQL提供pg_stat_database_conflicts视图,按数据库记录因恢复冲突被取消的查询,其中可区分旧快照、锁、缓冲区固定等原因。统计值是累计计数,验收时要取前后差额,并记录统计是否曾重置,不能把历史总量当成本次压测结果。
实际交付中可以让运维方提交一组能够相互对照的证据:同一段代表性报表的耗时和失败数、同期主库更新活动、备库重放进度,以及冲突分类的增量。先读错误日志,再用计数定位范围。若错误只是应用自己的执行超时,或服务器被内存不足终止,处理方向就不同;不能因为都表现为“报表失败”就套用恢复冲突的配置。
这也改变了购买服务的顺序。没有确认冲突种类之前,不把“增加内存后不再报错”写成验收承诺。供应商能够交付实例、系统权限和磁盘,并不自动表示它会调查数据库日志,更不表示会承担主备策略设计;这些工作应单独写进部署或维护服务范围。
主库已经清理的历史,备库不能一直留着
热备库既要为查询提供读取视图,也要应用主库已经产生的WAL。主库清理旧行版本形成的恢复记录,可能与备库仍需要这些版本的快照冲突;主库上的某些DDL和独占锁也会与备库读取冲突。官方文档明确说明,恢复不能拒绝应用已经在主库发生的动作,必要时会取消冲突查询,部分情形还会断开会话。
设想一份长报表在读取较早的数据视图,主库同时频繁修改并清理相同数据。备库若坚持把报表跑完,就可能推迟恢复记录的应用;若优先跟上主库,便可能结束仍在读的查询。这是示例机制,不是热陈互联的实测表现,也不代表每次清理都必然造成取消。是否真正冲突,要看被清理的数据、快照与重放时序。
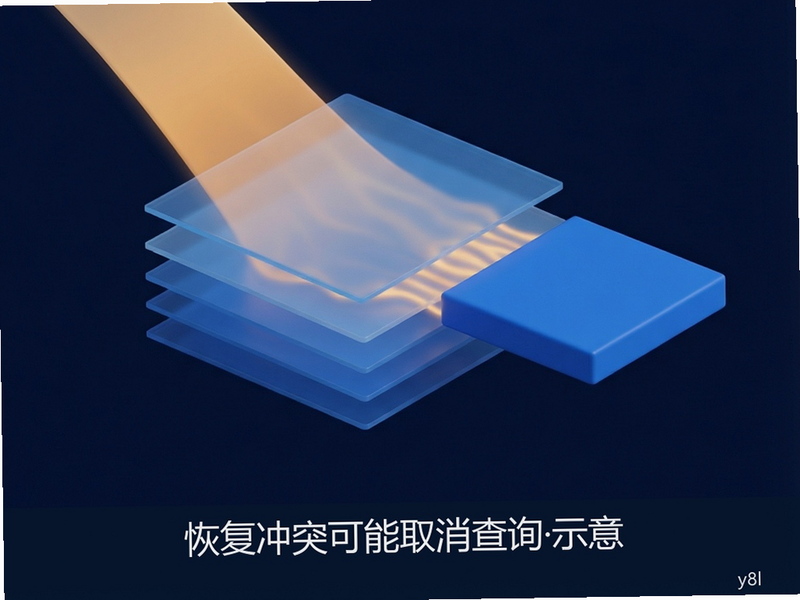
生成概念示意:读取历史与恢复动作在同一数据层交汇,不代表商家实测。
更快的CPU、合适的索引或更充足的缓存,有机会让查询提前结束,从而减少与恢复相遇的机会。若优化后报表在实际写入压力下能稳定完成,升级才有可观察的收益。但对于仍需长时间保留读取视图的作业,资源变化没有取消两种职责之间的约束。应在相同写入活动下复核,避免只在主库空闲时跑一次报表就签收。
三十秒参数不等于每条查询都有三十秒
官方对max_standby_streaming_delay的解释很具体:它限制的是流复制收到WAL后允许延迟应用的总时间,默认三十秒;它不是单条查询的最长执行时间。若前一条冲突查询已经消耗大量等待,后面的冲突查询在备库追上进度前,可能只得到很短的宽限。因此一条原本几秒完成的查询被取消,并不能证明“三十秒设置没生效”。
从采购角度,应询问运维交付的是哪一项承诺:正常报表完成率、最大允许的重放落后,还是故障接管时可用的数据范围。把参数调成更大,只是让系统更愿意等待查询,并没有直接增加机器处理能力。值为负一时可无限等待冲突查询结束,这对持续提供新数据的接管候选机可能很不合适。通过归档取得WAL时还存在对应的归档恢复等待设置,不能只核对流复制这一项。
开启反馈之后,账要回到主库核算
hot_standby_feedback可以把备库查询需要的历史信息反馈给上游,避免由清理记录造成的查询取消,但官方也提醒某些负载下会导致主库膨胀。它针对的是这一类清理冲突,不能承诺解决删表、删库或所有锁冲突。若报错分类没有核清,把反馈当成通用修复开关,会让主库承担额外空间成本,却仍留下查询失败。
对主库而言,为备库长查询保留旧版本,就意味着相应空间暂时不能按原来的节奏回收。需要观测的是更新活动和长查询重叠期间的空间增长、清理进度与后续回落情况,不能把某个时刻的剩余磁盘当成长期安全余量。备库断线后的反馈连续性也要纳入测试,不能只在连接稳定的理想条件下验收。
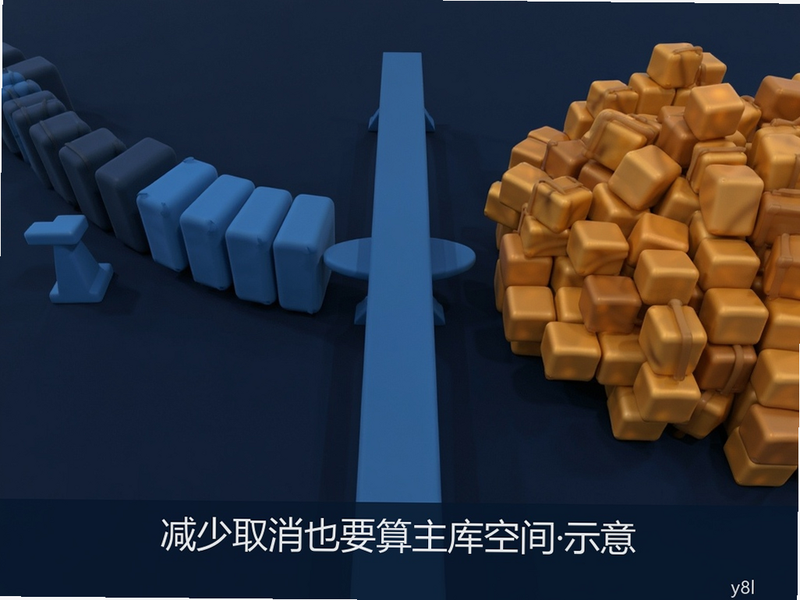
生成概念示意:等待队列与存量堆积表达时间和空间的取舍,不是实际容量数据。
这里不适合凭空套用一个“数据库大小乘几倍”的套餐推荐。可执行的估算应来自代表性窗口:以主库实际测得的额外保留空间增长速率,乘以预计最长的反馈影响时间,再加既有数据、维护活动和恢复所需的余量。这个乘积是容量规划的近似项,不是PostgreSQL保证值;行大小、索引和清理行为都会影响它。没有观测数据时,先要求采样,不把不确定性包装成准确配置。
报表备库减少取消的代价,可能表现为主库磁盘增长;只给备库扩盘,未必买到了正确位置的容量。因此主库和备库若分属不同订单或供应商,必须明确谁能修改反馈配置、谁负责监测主库空间、触及门槛时由谁终止报表。缺少这条责任链,再便宜的第二台机器也可能增加排障时间。
把两种用途分开报价,交付才有可签收的边界
对需要低落后接管的业务,备库应优先完成重放,报表允许取消后重试;应用需要明确错误处理和总执行期限。重试应受业务截止时间约束,不能在主库持续写入时无限重跑同一份长查询,放大读取负载。对允许较旧数据、但要求长报表稳定完成的业务,可以考虑独立分析副本,或将报表安排在独立恢复出来的数据集上。后一种方案还要另算恢复时间、数据更新频率与额外存储。
这不意味着所有团队都要买第三台机器。低频短报表若在实际更新峰值内也能按要求完成,原有备库可能足够;没有可接受的数据陈旧范围、又要求任意长报表从不取消,则应先调整服务目标。应把“报表最长完成时间”和“最大允许落后”同时写成业务门槛,在代表性更新负载下验证两者,而不是分别挑出最好的一次成绩。
如果考虑热陈互联,可通过热陈互联服务器推广入口,核对实例与运维报价了解可售方案。这是推广链接。本次取得的是渠道通实时接口中的商家记录与tracking_url,商家首页虽返回成功状态,却没有可读取的产品正文;现有商品库也没有足以引用的对应套餐参数。因此这里不报现价、不承诺库存、磁盘性能或数据库托管能力,具体配置与支持范围须由商家书面确认。
适合继续询价的场景,是团队愿意自管PostgreSQL、能取得主备所需权限,且已经定义好报表与接管职责。若需要供应商保证某个报表完成率或代管恢复策略,就应先确认服务是否出售、包含哪些测试。仅凭“云服务器”或“技术支持”字样,无法判断对方是否承接数据库层面的责任。
下单前把这些答案留在工单里
请商家确认操作系统与数据库参数由谁维护,是否允许设置恢复等待和反馈参数,能否取得主备日志及冲突统计,系统重启后参数由谁验证;再确认报表副本是否会被自动提升为主库、提升前如何判断重放状态。若主库也在同一供应商处,还应确认额外磁盘能否在线扩展、扩展计费周期及续费口径。任何没有书面答案的项目,都不要默认为套餐附带。
预算可以按实例费、主库新增保留空间费、运维调查与演练费、失败报表重跑成本分别记录,再比较一个完整使用周期。现在缺少商家报价,便只建立这些成本项,不编造总价。签收时保存配置实际值、一次有代表性的冲突分类差额、报表结果和同期重放进度;若启用反馈,再附主库空间变化。订单应为这些可验证结果负责,而不是为一张核数更多的参数表负责。
资料来源
最新文章
-
海外服务器建站一条龙:下单、远程连接、装面板、部署
这些年带过不少新手,服务器买好了,却卡在登录那一步,对着黑屏发怵。我把自己上手的
更新:26-11-02
-
外贸独立站用什么服务器?做跨境电商选机器这几点最关
这些年接触过不少做跨境的老板,独立站好不容易搭起来,却偏偏栽在服务器上要么旺季打
更新:26-11-02
-
WPAForge怎么用?无线密码审计常见问题解析
WPAForge 怎么用?本文围绕 WPAForge(无线密码审计工具) 的实际操作展开,从抓包、字典
更新:26-11-02
-
黑五前必看:海外服务器怎么选才不踩坑?建站、AI部署
干了十年,每年黑五都有人来问我服务器该怎么选。这篇把晚高峰怎么测线路、超售怎么看
更新:26-11-02
-
电子木鱼怎么用才有效果,敲木鱼真的能解压吗
电子木鱼怎么用才有效果?敲木鱼真的能解压吗?这篇就把我用了大半个月的真实感受说清
更新:26-11-02
-
十字军之王3贸易怎么开 十字军之王3怎么赚钱
配送航线没有金币收入,商人利润也不能只看价差。10月27日官方贸易日志让两类经营目标
更新:26-11-02
COMMENTS 网友评论





推荐文章
热门文章
 2026年世界杯小组赛好看吗?世界杯2026
26-05-14
 2026年世界杯预选赛在哪里看 世界杯足球
26-05-14
 VMware ESXi 9.0如何使用 ESXi 9.0激活
25-09-15
 2026捕鱼游戏那个最火 捕鱼游戏推荐哪个
26-01-16
 lmarena生成手办指令 lmarena怎么生成3
25-09-02
 HttpCanary怎么用 httpcanary打不开如何
25-09-02
 黄金交易平台app排行榜 贵金属黄金交易
25-07-14
 追番动漫软件推荐app2026 追番的免费软
25-07-14
 永久免费的追剧软件无广告 2026永久免费
25-07-14
 和平精英手游是刺激战场吗 腾讯光子和平
19-05-08