网页爬虫(Web Crawler)
网页爬虫手机端就能跑采集,填表式配置不用写代码,抓表格导CSV挺顺手,找网页爬虫工具的朋友可以试试。 发表评论
- 软件类别:网络应用
- 软件大小:138KB
- 更新时间:2026-10-23 19:30
- 软件版本:v1.0 网页数据抓取工具
- 软件语言:中文
- 软件等级:
- 软件厂商:
- 官方网址:暂无
- 备案号:
- 评分
- 安卓版下载
手机扫描下载
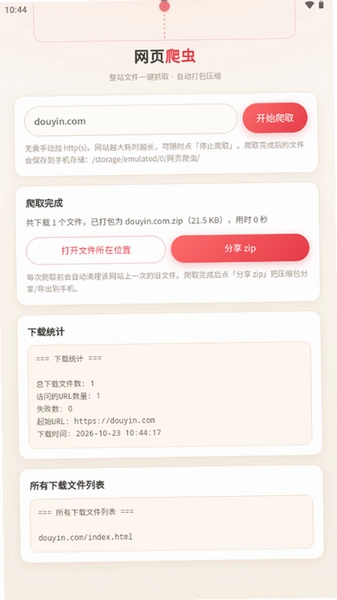
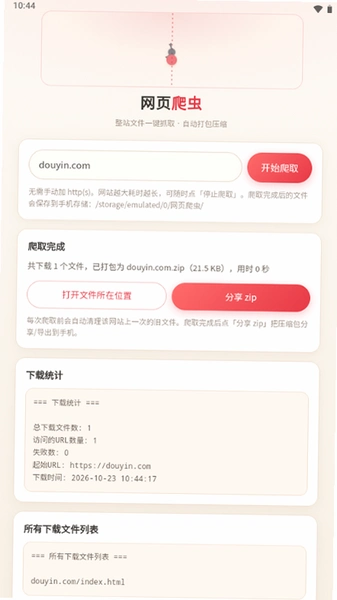
应用介绍
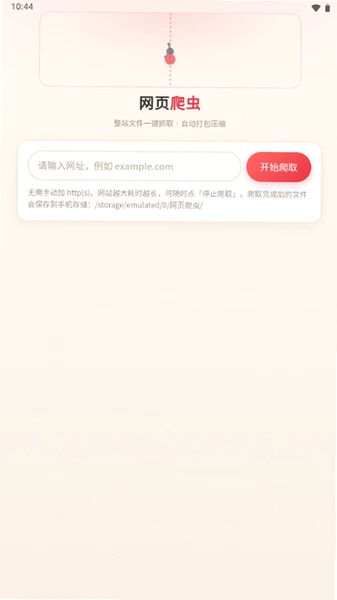
手机端想抓取网页上的表格、图片或者小说章节,又不想开电脑折腾Python环境,这类需求其实挺常见的。网页爬虫把抓取规则做成了图形化配置,在安卓机上就能完成链接提取、数据导出这类操作,省去了装库、配环境的麻烦。它跟那些需要敲代码的采集方案不太一样,更偏向"填表式"操作输入目标网址、圈选要抓的区域、设定翻页规则,剩下的交给软件跑。对于做竞品价格监控、收集公开资料、整理小说章节这些场景,算是个轻量选择。不过要提醒一句,抓取行为得守着 robots 协议和网站版权边界,拿公开数据做个人整理没问题,大规模商业采集还是得走正规授权渠道。下面从安装、实操、避坑几个角度聊聊这款工具到底怎么用。
网页爬虫APP在哪下载安装比较稳妥?
1. 安卓端没有上架主流应用商店,搜"网页爬虫"出来的结果鱼龙混杂,建议直接在本站资源页找安装包,页面底部有明确的下载按钮,点进去就能拿到apk文件。
2. 下载前先看一眼文件大小和版本号,确认是1.0正式版再动手,别下到改过签名的二次打包版本。
3. 安装时系统会弹"未知来源应用"的提示,去设置→安全→允许安装未知应用,把浏览器或者文件管理器的开关打开就行。
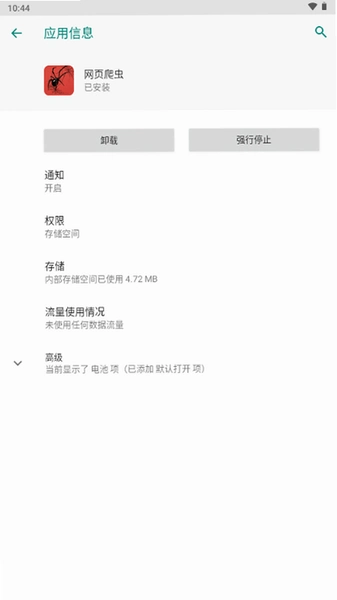
4. 装完第一次打开,软件会申请存储权限,用来存抓取下来的图片和CSV文件,这个权限躲不掉,不给的话导出功能直接罢工。
5. 如果手机是鸿蒙或者MIUI系统,可能还要在应用管理里手动给"读写手机存储"打勾,不然抓完数据找不到文件存哪了。
6. 安装包体积不大,实测在千元机上安装耗时不到十秒,比装个大型游戏轻快多了。
网页爬虫抓取规则怎么设置?新手实操步骤拆解
1. 打开软件主界面,点右下角"+"号新建任务,第一栏填目标网址,支持http和https,带不带www都行。
2. 进入"字段配置"页,点"添加字段",软件会加载网页源码,用手指长按你要抓的文字区域,它会自动识别对应的CSS选择器,比自己手写xpath省事。
3. 翻页规则在"高级设置"里,选"下一页链接"模式,然后点一下网页底部的"下一页"按钮,软件记住这个元素的特征,后面就自动翻页了。
4. 抓取深度建议先设成3层试跑,确认数据准确再往上加,一上来就设几十层容易把任务跑崩。
5. 导出格式支持CSV和JSON两种,CSV用Excel直接打开,JSON适合丢给后端做二次处理,按需选就行。
6. 跑任务的时候别切后台太频繁,实测切到微信聊两分钟再回来,偶尔会断掉当前页的抓取,得手动点继续。
网页爬虫常见的反爬虫机制有哪些?软件能应付吗
1. 最基础的是UA检测,网站发现请求头里没有浏览器标识就直接拒绝。这款软件在"请求设置"里内置了UA伪装开关,打开后模拟Chrome的请求头,能绕过一部分轻量级拦截。
2. 频率限制也常见,同一IP短时间请求太多会被封。软件支持设置"请求间隔",建议调到1.5秒以上,别贪快,跑得稳比跑得快重要。
3. 验证码这块得说实话,软件没有内置打码功能,遇到滑块或者图形验证码只能手动停任务去处理,这是它的短板,别指望全自动。
4. 有些网站用JS动态渲染内容,源码里抓不到数据,软件对这类页面的支持有限,遇到抓出来是空的情况,多半是撞上动态加载了。
5. 登录态抓取需要手动在软件内置浏览器里登录一次,cookie会保存下来,但有效期跟着网站走,过期了得重新登。
6. 对比电脑端的八爪鱼采集器,这款手机版在反爬对抗上功能少一些,胜在随时随地能跑,适合轻量任务。
网页爬虫抓下来的数据怎么导出和整理?
1. 任务跑完后进"任务列表",点已完成的任务,右上角有"导出"按钮,选CSV格式会存到手机存储的CrawlerData文件夹里。
2. 导出的CSV用WPS或者Excel手机版打开,中文编码选UTF-8,不然容易出现乱码。
3. 图片类资源会单独存一个文件夹,按任务名分类,抓之前最好在设置里把"图片压缩"关掉,保留原图质量。
4. 数据量大的话建议分批导出,单次超过五千条记录,手机处理起来会卡顿,分两三次跑更稳妥。
5. 软件没有内置数据清洗功能,去重、筛选这些操作得导出来用表格工具做,别指望它一步到位。
网页爬虫和Python爬虫比,差在哪儿?
1. 灵活性上Python肯定碾压,想怎么定制都行,但网页爬虫胜在零代码门槛,不用装Python、不用配pip源,装个apk就能跑。
2. 内存占用方面,实测软件常驻内存大概80MB左右,比在手机上跑Termux加Python环境省不少,后者光环境就得占两百多兆。
3. 复杂逻辑处理上,Python能写条件判断、循环嵌套,这款软件只能做线性规则配置,遇到需要登录后跳转再抓取的场景就吃力了。
4. 稳定性这块,Python脚本可以挂服务器跑几天几夜,手机端软件受限于系统省电策略,长时间任务容易被杀后台,适合短平快的采集。
5. 学习成本反过来看,Python爬虫得懂requests、BeautifulSoup这些库,网页爬虫看一遍教程就能上手,对非技术背景的用户友好得多。
网页爬虫基础操作与实测体验
| 功能模块 | 实测表现 |
| 新建任务 | 输入网址后自动解析页面结构,耗时约3秒,支持http/https |
| 字段选取 | 长按圈选即可生成选择器,实测对表格和列表页识别准确率较高 |
| 翻页设置 | 支持下一页链接和页码递增两种模式,翻页按钮识别偶尔需要手动校正 |
| 请求间隔 | 可设0.5秒到10秒,建议不低于1.5秒,实测1秒间隔跑百页任务被封过一次 |
| 导出格式 | CSV和JSON双格式,CSV中文需选UTF-8编码,否则乱码 |
| 内存占用 | 常驻约80MB,跑任务时峰值到130MB左右,千元机可承受 |
实测短板披露:存储权限不给就罢工,这点对隐私敏感用户不太友好;长时间任务切后台容易被系统杀掉,得把软件加进电池优化白名单;遇到动态渲染页面抓出来是空的,没有提示原因,新手容易懵。
用户问答专区
问:网页爬虫抓小说章节,翻页翻到一半停了咋回事?
答:多半是触发了网站的访问频率限制,去任务设置里把请求间隔从默认的0.5秒调到2秒以上,然后把任务删了重新建,从断掉的那章接着跑。别在原任务上点继续,容易重复抓取。
问:装完之后打开闪退,是不是手机不兼容?
答:先看系统版本,安卓7.0以下的机器跑不起来,这是硬性要求。如果是新系统还闪退,去应用管理里把存储权限手动打开再试,权限没给全有时候会直接崩。
问:抓下来的图片存在哪个文件夹了?
答:默认在手机存储根目录的CrawlerData文件夹下,按任务名分子文件夹。如果找不到,在软件设置里把"自定义存储路径"打开,指向你熟悉的目录就行。
问:这软件抓数据合法吗?会不会有风险?
答:工具本身中立,关键看抓什么、怎么用。抓公开的、不涉及个人隐私和版权保护的内容,自己整理资料没问题。批量抓取受版权保护的内容或者绕过网站付费墙,那就踩线了。用之前看一眼目标网站的robots.txt,里面写了允许抓哪些路径。
问:为什么抓出来的表格数据缺了几列?
答:检查字段配置里有没有漏配列,长按选取的时候可能只圈到了第一列。进字段管理手动补上缺少的列选择器,或者换个方式直接选整个表格元素,让软件自动拆分列。
同类采集工具备选清单
应用信息
- 包名:org.example.webcrawler
- 名称:网页爬虫
- 版本:1.0
- MD5值:76e4479b2738774ff466ba618b0ab5e4
热门专题
本类最新
 大小:45.7M
网友评论
相关应用
 WeeWaa体感运动(WeeWaa Sports)v2.7 体感燃脂健身
WeeWaa Sports把体感识别和燃脂训练结合到一起,手机架
 ContinueBrowser浏览器(继续浏览器)v1.1.1 轻量极简浏览
ContinueBrowser浏览器主打轻量无广告,打开即搜索,没
 鲸歌(WhaleBeat)电视音乐播放器v1.3.3 电视音乐点播
鲸歌是一款面向智能电视和电视盒子的音乐点播软件,用
 串烧果酱(Skewer Jam)v1.98.5 休闲串烧消除
串烧果酱(Skewer Jam)是一款把串烧和消除揉在一起的休
 网页电视TV版免费v1.8.1 电视直播应用
网页电视这款安卓直播工具把央视、卫视和地方台聚合在
热门推荐
 谷歌浏览器app下载安装手机版本(Chrome)v151.0.7922.108网络应用
 心动浏览器手机版v1.1.61安卓版网络应用
 vivo浏览器官方正版下载v31.1.70.0网络应用
 360浏览器app下载安装最新版本v10.1.7.260网络应用
 夸克app官方正版下载最新版本v10.19.5.1170网络应用
本类排行
- 1谷歌浏览器app下载安装手机版本(Chrome)v151.0.7922.10812.7M
- 2谷歌云端硬盘app(Google Drive)v2.26.357.0.all.alldpi101.0M
- 3超强极速wifi安卓版v1.3.4最新版29.3M
- 4追回神器中转站v1.212M
- 5追回神器3.35老版本12M
- 6nube搜索引擎安卓版v1.1.03.0M
- 7qq浏览器app下载安装免费正版v20.7.0.0062148.3M
- 8百度极速版2026年最新版下载安装v7.23.0.1072.6M
- 9kiwi浏览器手机官方版下载(Kiwi Browser)v137.0.7337.0232.9M
- 10环宇浏览器安卓版v1.6手机版1.9M